L'impératif économique face à la prolifération des requêtes génératives
L'intégration de capacités cognitives artificielles au sein des applications d'entreprise modifie fondamentalement la structure des coûts informatiques. Les modèles fondationnels de très grande taille offrent des performances remarquables pour des tâches complexes impliquant un raisonnement sophistiqué. Leur utilisation systématique pour l'intégralité des requêtes génère toutefois une dérive budgétaire insoutenable à grande échelle. La facturation à l'usage, indexée sur le volume de tokens traités, transforme chaque interaction utilisateur en un centre de coût variable qu'il convient de maîtriser avec la plus grande rigueur.
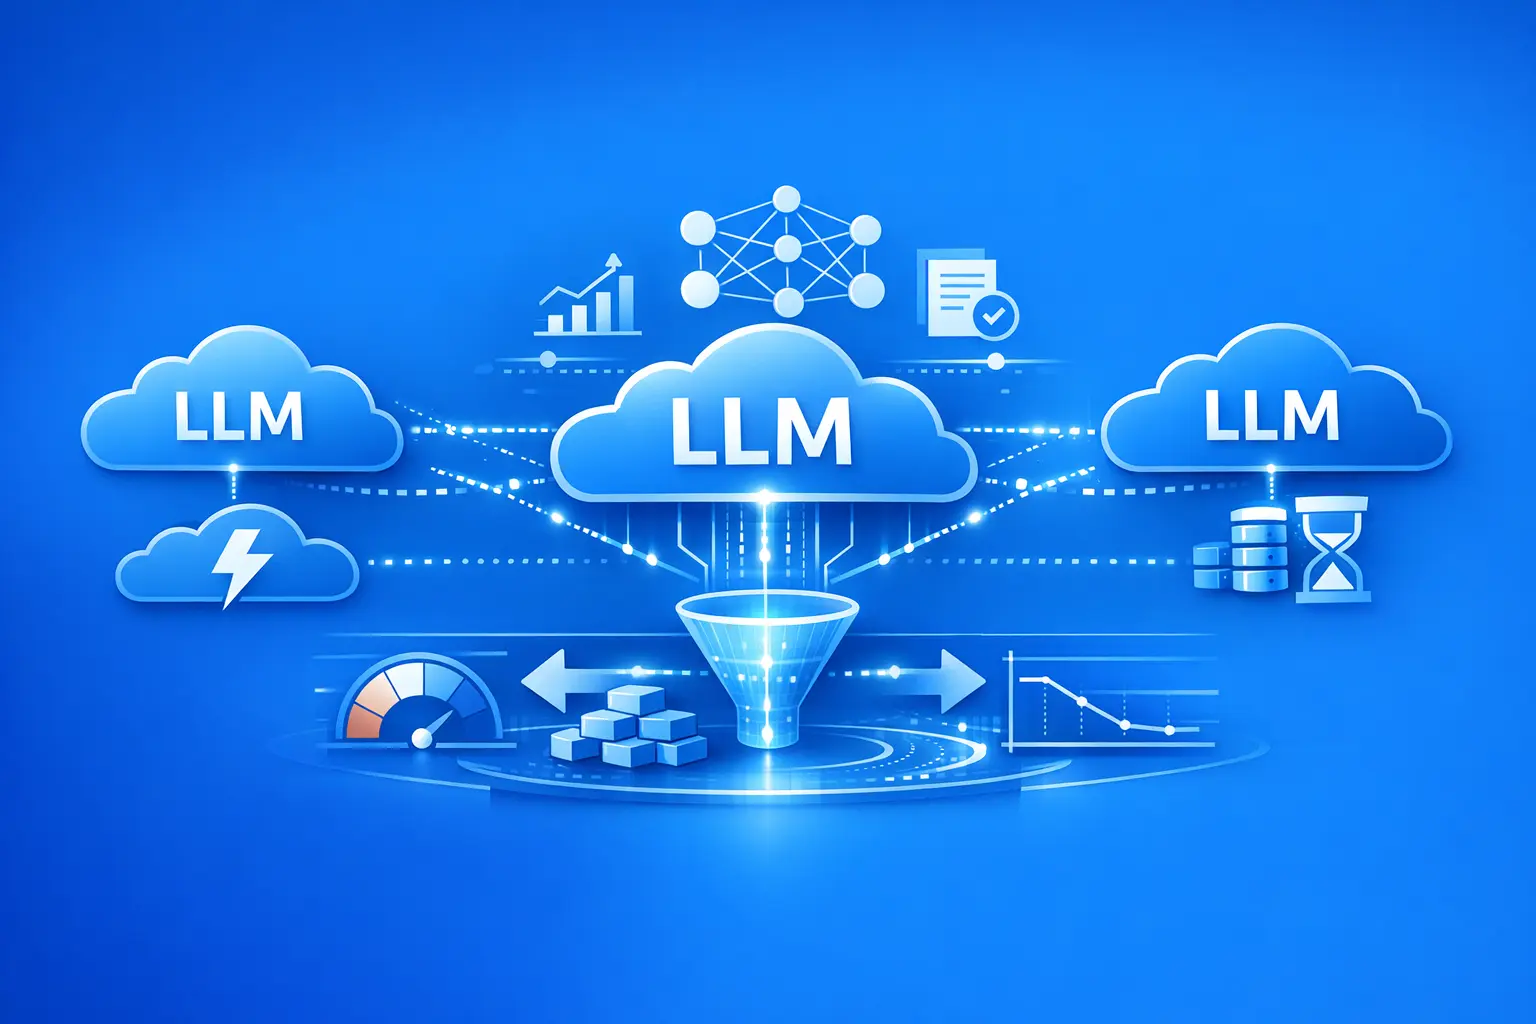
Face à cette asymétrie financière, l'architecture logicielle doit s'adapter pour introduire une couche d'intelligence intermédiaire. Le concept de routage dynamique émerge comme la réponse technique la plus pertinente. Il s'agit de concevoir un système capable d'analyser la nature d'une requête entrante pour la diriger vers le modèle de langage le plus approprié. Une simple demande de formatage de texte ne justifie pas la mobilisation de la puissance de calcul d'un modèle paramétré à plusieurs centaines de milliards de variables. Un modèle plus compact exécutera cette tâche avec une vélocité supérieure et un coût marginal dérisoire.
L'enjeu consiste à établir une taxonomie précise des cas d'usage internes. Vous devez cartographier les interactions prévues entre vos utilisateurs et vos systèmes pour identifier les variations de complexité. Cette démarche analytique permet de structurer une stratégie d'allocation des ressources où l'excellence algorithmique est strictement réservée aux requêtes à haute valeur ajoutée. Les tâches routinières sont quant à elles déléguées à des modèles spécialisés ou de taille réduite. Cette rationalisation de l'effort computationnel garantit la rentabilité de vos services applicatifs sans dégrader l'expérience finale.
Mécanique du routage sémantique et catégorisation des flux
La mise en œuvre d'un routage intelligent repose sur des mécanismes de classification exécutés en amont de toute génération de texte. Lorsqu'une application cliente émet un prompt, ce dernier est immédiatement intercepté par une passerelle applicative dédiée. Ce composant évalue instantanément l'intention de l'utilisateur pour déterminer la destination optimale de la charge de travail.
Le routage sémantique utilise généralement des techniques avancées de vectorisation. Le système transforme la requête textuelle en un vecteur mathématique pour la comparer à une base de données d'intentions préalablement définies. Si la similarité spatiale avec une catégorie connue dépasse un seuil de confiance spécifique, le routeur applique la règle d'affectation correspondante. Cette opération s'exécute en quelques millisecondes et n'introduit qu'une friction négligeable dans le cycle de vie de la requête globale.
Pour affiner cette prise de décision en temps réel, l'architecture évalue de multiples paramètres techniques de manière simultanée :
- La longueur exacte de la fenêtre de contexte requise pour traiter les documents fournis.
- Le niveau de raisonnement logique exigé par la consigne initiale de l'utilisateur.
- La sensibilité des informations transmises selon les critères de classification internes de l'entreprise.
- La tolérance à la latence du système appelant.
- Le format de sortie structuré spécifié par le contrat d'interface.
- Le coût unitaire par token généré imposé par les contraintes budgétaires du projet.
L'analyse combinée de l'ensemble de ces facteurs permet au routeur de sélectionner le canal d'exécution idéal. Si la requête implique l'analyse d'un volumineux rapport financier pour en extraire des entités nommées spécifiques, le système privilégiera un modèle doté d'une large fenêtre de contexte couplé à une forte capacité d'extraction factuelle. À l'inverse, une demande d'autocomplétion de code source s'orientera vers un modèle ultra-spécialisé dans la syntaxe des langages de programmation.
Critères d'arbitrage technologique et optimisation de la latence
Le choix du modèle ne se résume pas à une simple équation financière. La performance perçue par l'utilisateur final dépend intrinsèquement du temps de réponse du système sous-jacent. Les grands modèles de langage présentent mécaniquement un délai d'inférence supérieur en raison de leur architecture massive impliquant des calculs matriciels gigantesques. La métrique du temps d'attente avant l'apparition du premier token constitue un indicateur critique pour la viabilité des applications conversationnelles interactives.
En orientant les requêtes simples vers des modèles comptant moins de dix milliards de paramètres, vous réduisez drastiquement la latence globale de votre application métier. Ces modèles compacts démarrent la génération de texte de manière quasi instantanée. Pour consolider cette approche architecturale, les experts de l'entreprise Dexon préconisent la mise en place de stratégies de repli en cascade. Si un modèle rapide échoue à fournir une réponse avec un niveau de certitude suffisant, la passerelle redirige automatiquement la requête vers un modèle plus performant sans nécessiter d'intervention humaine.
Ce mécanisme d'escalade cognitive garantit une résilience exceptionnelle à l'ensemble du système. Vous bénéficiez de la fulgurance des petits modèles pour la grande majorité des interactions courantes tout en conservant l'expertise des modèles de pointe pour traiter les cas limites ou les requêtes particulièrement ambiguës. La configuration fine de ces seuils de bascule requiert une analyse rigoureuse des métriques de production. L'objectif technique est de trouver le point d'équilibre exact où l'économie générée par le routage compense largement la surconsommation induite par les rares requêtes nécessitant une double exécution séquentielle.
Sécurisation des données et souveraineté par l'hybridation des modèles
L'intégration massive de l'intelligence artificielle soulève des interrogations légitimes quant à la confidentialité absolue des informations traitées. Le recours exclusif à des interfaces de programmation hébergées par des fournisseurs tiers expose les organisations à des risques structurels de fuite de données ou de non-conformité réglementaire. Le routage intelligent offre une solution architecturale robuste pour concilier la puissance générative moderne et la souveraineté numérique indispensable aux grandes entreprises.
En déployant une infrastructure résolument hybride, vous dotez votre système d'information de la capacité à discriminer les flux réseau selon leur niveau de criticité. Lorsqu'un utilisateur soumet un prompt contenant des données à caractère personnel ou des secrets industriels majeurs, le routeur identifie immédiatement cette sensibilité grâce à des algorithmes spécialisés dans la détection d'entités nommées. La requête est alors impérativement orientée vers un modèle de langage open source hébergé sur vos propres serveurs physiques ou au sein de votre environnement cloud privé sécurisé.
À l'inverse, les questions d'ordre purement général ou les demandes de synthèse portant sur des documents strictement publics sont dirigées vers les modèles commerciaux les plus performants du marché mondial. Cette ségrégation physique et logique des flux garantit un respect scrupuleux des exigences de conformité liées au Règlement Général sur la Protection des Données. Vous conservez ainsi la maîtrise absolue de votre patrimoine informationnel sans pour autant priver vos collaborateurs des avancées technologiques spectaculaires offertes par les grands acteurs du secteur numérique.
Implémentation architecturale d'une passerelle décisionnelle unifiée
La concrétisation opérationnelle de cette stratégie d'optimisation requiert le déploiement d'une brique d'infrastructure spécifique agissant comme un point d'entrée unique pour l'ensemble des appels liés à l'intelligence artificielle. Cette passerelle applicative centralise la gestion stricte des clés d'authentification, l'application uniforme des politiques de sécurité et l'exécution implacable du moteur de règles de routage. Elle isole totalement les applications clientes de la complexité inhérente à la multiplicité des fournisseurs de modèles de langage.
L'ajout d'un système de mise en cache sémantique au sein de cette même passerelle amplifie considérablement les gains financiers escomptés. Lorsqu'une requête entrante présente une similarité vectorielle très élevée avec une question précédemment traitée par le système, la passerelle restitue directement la réponse stockée en mémoire vive. Ce mécanisme d'interception annule purement et simplement le coût de l'inférence externe et réduit la latence perçue à quelques millisecondes. L'analyse détaillée des références de déploiement en environnement d'entreprise démontre que la combinaison d'un routeur intelligent couplé à un cache sémantique constitue le levier d'optimisation le plus puissant pour les architectures soumises à un fort trafic concurrent.
Cette centralisation architecturale facilite par la suite l'intégration fluide de nouveaux modèles au sein de votre écosystème applicatif. Le marché de l'intelligence artificielle évolue à un rythme effréné avec la publication régulière de modèles toujours plus efficients. L'architecture articulée autour d'une passerelle vous permet de modifier vos cibles de routage par une simple configuration déclarative sans nécessiter la moindre modification du code source de vos applications métiers. Vous conservez ainsi une agilité technologique indispensable pour capitaliser sur les innovations futures tout en maîtrisant votre dette technique.
Mesure de la valeur et ajustement continu des règles d'affectation
Le déploiement initial d'une architecture de routage ne constitue pas une fin en soi. Son efficacité sur le long terme repose sur une gouvernance pilotée par la donnée factuelle et une surveillance constante des métriques d'exécution en temps réel. Vous devez implémenter une couche d'observabilité complète pour tracer chaque interaction individuelle, mesurer précisément la consommation de tokens par modèle spécifique et évaluer rigoureusement les temps de réponse associés à chaque fournisseur.
La collecte centralisée de ces données télémétriques permet de générer des tableaux de bord financiers d'une grande précision. Vous obtenez une visibilité granulaire inédite sur les coûts engendrés par chaque département de l'entreprise, chaque application logicielle ou chaque type de tâche cognitive. Cette transparence opérationnelle est absolument indispensable pour responsabiliser les acteurs métiers impliqués et justifier les investissements technologiques auprès de votre direction financière.
L'analyse continue des journaux d'exécution met régulièrement en lumière de nouvelles opportunités d'optimisation architecturale. Si vous constatez qu'une catégorie spécifique de requêtes dirigée par défaut vers un modèle compact génère systématiquement des évaluations négatives de la part des utilisateurs finaux, vous disposez des leviers nécessaires pour ajuster vos règles de routage. Vous déciderez alors d'allouer dynamiquement un modèle doté de meilleures capacités de raisonnement abstrait à cette tâche particulière.
Pour structurer efficacement cette démarche d'amélioration continue au sein de votre organisation, deux actions fondamentales s'imposent :
- L'organisation systématique de revues mensuelles dédiées à l'analyse des métriques de performance technique comparées aux coûts réels d'exploitation.
- La mise à jour itérative de la base d'intentions sémantiques pour refléter fidèlement l'évolution réelle des usages constatés auprès de vos collaborateurs.
Cette boucle de rétroaction vertueuse garantit que votre architecture reste parfaitement alignée avec vos objectifs économiques stratégiques et vos exigences qualitatives sur le très long terme. L'intelligence artificielle cesse définitivement d'être perçue comme une boîte noire budgétaire imprévisible pour devenir un véritable service d'infrastructure prédictible, finement mesurable et parfaitement gouverné par vos équipes d'ingénierie.