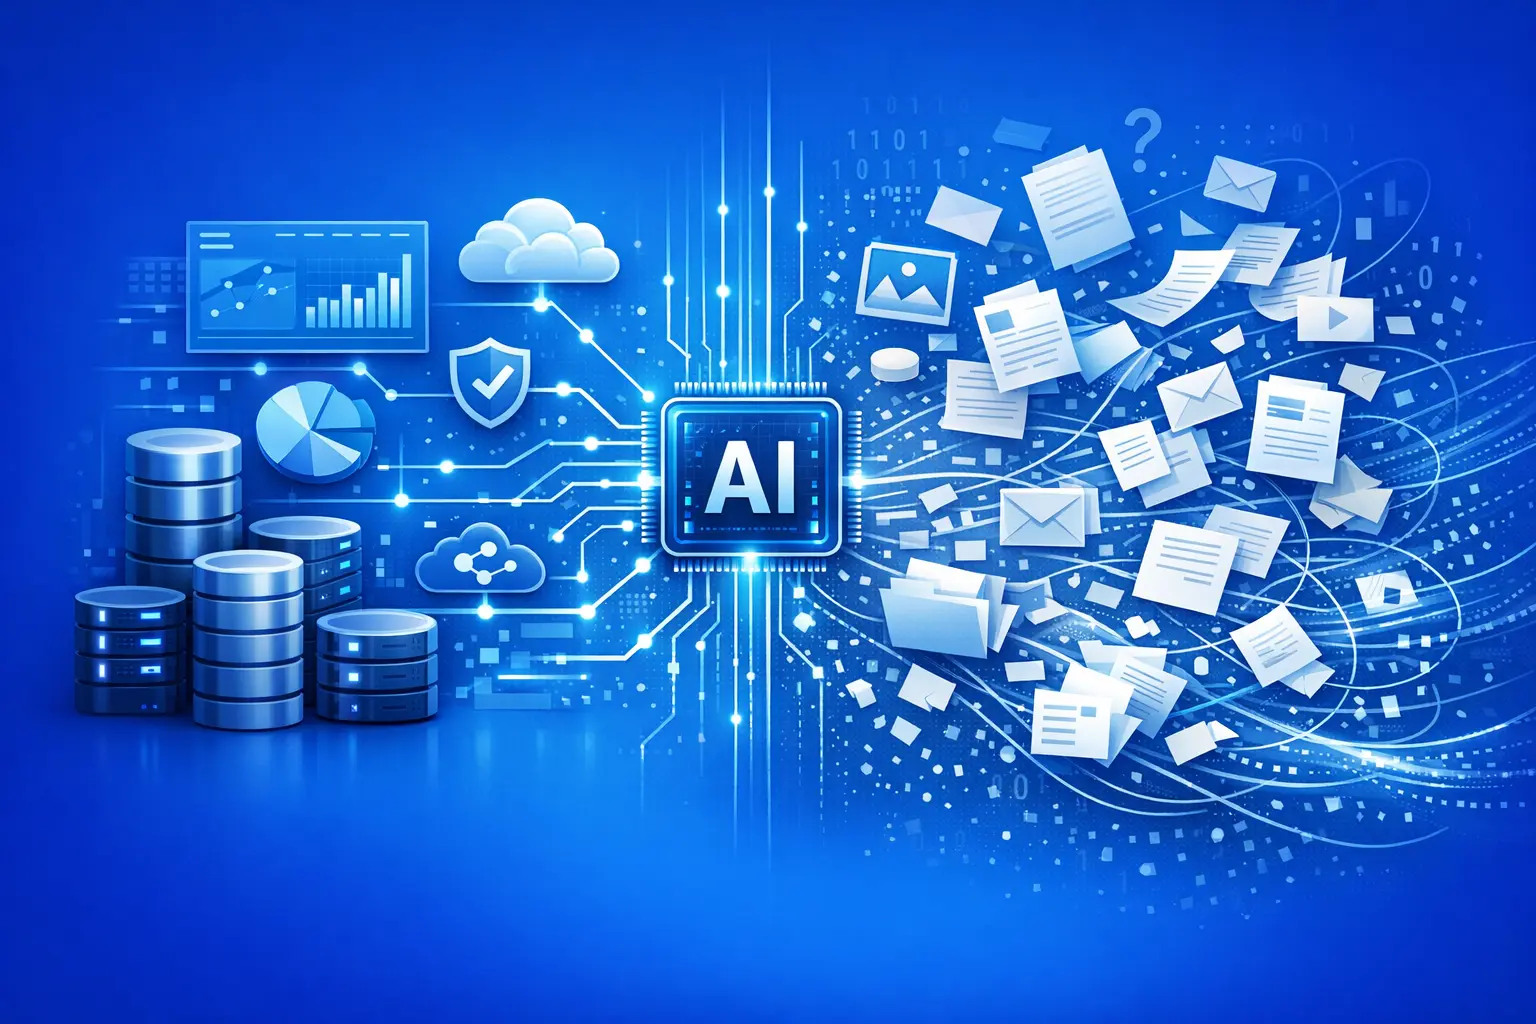
Historiquement, les directions des systèmes d'information concentraient leurs efforts de gouvernance sur les données structurées. Les bases de données relationnelles, les progiciels de gestion intégrés et les entrepôts de données bénéficiaient de cadres stricts, de dictionnaires précis et de processus de validation rigoureux. Aujourd'hui, l'émergence des grands modèles de langage modifie fondamentalement cette dynamique. Les algorithmes d'intelligence artificielle se nourrissent majoritairement d'informations non structurées : documents textuels, courriels, transcriptions de réunions, vidéos ou encore journaux d'événements. Ce gisement représente généralement la vaste majorité des actifs numériques d'une organisation.
L'absence de schémas prédéfinis caractérisant ces formats rend leur exploitation particulièrement complexe. Lorsqu'une entreprise déploie une solution d'intelligence artificielle interne, elle connecte souvent ces algorithmes à des corpus documentaires hétérogènes. Sans une supervision adéquate, l'algorithme ingère indifféremment des notes de service obsolètes, des brouillons stratégiques confidentiels ou des documents validés par la direction juridique. Cette ingestion aveugle génère un risque systémique pour la qualité des résultats produits.
Le Data Governance Officer (DGO) intervient précisément à cette intersection. Sa mission consiste à transformer un amas documentaire chaotique en un socle de connaissances qualifié, sécurisé et exploitable par les machines. Il ne s'agit plus seulement de documenter des tables SQL, mais d'imposer un cadre de gestion à des éléments par nature insaisissables. Votre organisation doit impérativement structurer l'implicite pour éviter que l'intelligence artificielle n'amplifie la désorganisation existante.
Le repositionnement stratégique du Data Governance Officer
La fonction de Data Governance Officer a longtemps été perçue sous le prisme unique de la conformité réglementaire. Ce professionnel assurait le respect du RGPD, maintenait les registres de traitement et veillait à la minimisation des collectes. À l'ère de l'intelligence artificielle de masse, son rôle prend une dimension éminemment stratégique. Il devient l'architecte de la confiance numérique au sein de votre structure.
Le DGO doit désormais orchestrer la collaboration entre les experts métiers, les équipes juridiques, les architectes data et les spécialistes en intelligence artificielle. Il établit les règles définissant quelles informations peuvent alimenter les bases de données vectorielles utilisées par les systèmes de génération augmentée par la recherche (RAG). Cette responsabilité exige une compréhension fine des enjeux d'affaires et des contraintes technologiques. Comme nous l'observons lors de nos interventions via notre site, les organisations qui réussissent leur transition algorithmique sont celles qui intègrent le DGO dès la phase de conception de leurs cas d'usage.
Ce repositionnement implique également une évolution des compétences. Le DGO moderne maîtrise les concepts de sémantique, comprend les mécanismes de vectorisation et appréhende les limites des modèles génératifs. Il élabore des politiques de cycle de vie adaptées aux documents textes, définit les métadonnées obligatoires pour chaque type de contenu et supervise les mécanismes de purge. Son action garantit que les initiatives basées sur l'intelligence artificielle reposent sur un socle de vérité irréprochable.
Cartographie et classification des corpus documentaires
La première étape pour endiguer le chaos des informations non structurées consiste à établir une cartographie exhaustive. Vous ne pouvez pas gouverner ce que vous ne connaissez pas. Le DGO déploie des stratégies de découverte automatisée pour identifier les silos d'informations disséminés sur les serveurs de fichiers, les intranets, les espaces collaboratifs et les postes de travail.
Une fois ces gisements identifiés, une classification rigoureuse s'impose. Cette démarche nécessite l'établissement d'une taxonomie d'entreprise claire et partagée. L'objectif est d'associer des métadonnées enrichies à chaque document pour compenser son absence de structure interne. Le cadre méthodologique mis en place par le Data Governance Officer doit obligatoirement s'articuler autour des axes suivants :
- Identification exhaustive des sources primaires d'information textuelle ou multimédia présentes dans le système.
- Définition des ontologies métiers spécifiques permettant de relier sémantiquement les concepts de l'organisation.
- Attribution systématique des responsabilités par domaine métier pour garantir la validation humaine des corpus.
- Établissement des règles de durée de conservation des documents selon les contraintes légales et opérationnelles.
- Catégorisation des niveaux de confidentialité pour restreindre l'accès aux algorithmes selon les habilitations.
- Traçabilité complète du cycle de vie depuis la création du document jusqu'à son archivage définitif ou sa destruction.
Cette structuration par les métadonnées transforme les fichiers isolés en actifs interrogeables. Elle permet aux systèmes d'intelligence artificielle de filtrer les sources lors de l'exécution d'une requête, garantissant ainsi que seules les informations pertinentes, validées et autorisées sont utilisées pour générer une réponse.
L'identification et la mitigation des risques liés à l'ingestion algorithmique
L'utilisation de données non structurées non gouvernées par des modèles d'intelligence artificielle expose votre entreprise à des menaces considérables. Le DGO porte la responsabilité d'identifier ces vecteurs de risque et d'implémenter les garde-fous nécessaires. La confiance des utilisateurs finaux envers les outils déployés dépend directement de la fiabilité des informations restituées.
L'absence de contrôle sur les corpus documentaires engendre des conséquences directes sur la pertinence et la sécurité des systèmes mis en production. Le DGO concentre particulièrement son attention sur les périls suivants :
- La contamination des espaces vectoriels par des documents obsolètes ou inexacts, provoquant des hallucinations algorithmiques et des réponses erronées lors de l'interrogation des modèles par les collaborateurs.
- L'exposition involontaire de données à caractère personnel ou de secrets industriels due à une gestion déficiente des habilitations d'accès lors de l'indexation des fichiers non structurés.
Pour contrer ces menaces, le DGO collabore étroitement avec les équipes de cybersécurité pour appliquer les principes du moindre privilège aux pipelines d'ingestion. Il s'assure que les droits d'accès définis au niveau des systèmes de fichiers sont scrupuleusement répliqués au sein des bases de données vectorielles. Ainsi, un collaborateur interrogeant un modèle génératif interne ne pourra jamais obtenir d'informations issues d'un document auquel il n'a pas légitimement accès.
Méthodologies d'assainissement et standards de qualité
L'assainissement des données non structurées requiert une approche méthodique. Le DGO s'appuie souvent sur des cadres de référence reconnus, tels que le corpus de connaissances DAMA-DMBOK, qu'il adapte aux spécificités des formats textuels et multimédias. La qualité d'un document ne se mesure pas de la même manière que la qualité d'une cellule dans une table de base de données.
Le DGO met en œuvre des contrats de données (Data Contracts) spécifiques aux sources non structurées. Ces contrats définissent les attentes en matière de formatage, de présence de métadonnées et de fraîcheur de l'information. Par exemple, un contrat peut stipuler que tout compte rendu de comité de direction doit inclure une balise de confidentialité stricte et être systématiquement converti dans un format lisible par les algorithmes d'extraction. Les références de notre cabinet illustrent la nécessité d'implémenter ces standards de qualité pour garantir le succès des projets de transformation.
L'assainissement passe également par la déduplication et l'archivage. Les serveurs d'entreprise regorgent de copies multiples d'un même document, souvent modifiées à la marge. Le DGO déploie des outils d'analyse sémantique pour identifier ces doublons et déterminer la version de référence (Golden Record). Cette démarche réduit les coûts de stockage, optimise les temps de traitement algorithmique et élimine les contradictions potentielles lors de la génération de contenu par l'intelligence artificielle.
Mesurer la valeur et pérenniser l'architecture de gouvernance
La gouvernance des données non structurées s'inscrit dans une démarche d'amélioration continue. Le Data Governance Officer doit démontrer la valeur apportée par ses initiatives à la direction générale. Cette démonstration repose sur la définition et le suivi d'indicateurs de performance clés (KPI) spécifiques au monde non structuré.
Ces indicateurs incluent le volume de documents orphelins supprimés, le pourcentage de fichiers correctement classifiés par les outils automatisés, le nombre d'incidents de sécurité évités grâce à la restriction des accès vectoriels et l'amélioration de la précision des réponses fournies par les modèles génératifs internes. Le DGO organise des audits réguliers pour vérifier que les processus de qualification documentaire sont respectés par les directions métiers.
La pérennisation de cette architecture exige un changement culturel important. Le DGO consacre une part significative de son temps à l'acculturation des collaborateurs. Il explique comment la rédaction soignée d'un document, l'attribution correcte d'un titre et le respect des conventions de nommage impactent directement l'efficacité de l'intelligence artificielle de l'entreprise. En responsabilisant chaque créateur de contenu, le Data Governance Officer transforme la gestion des informations non structurées en un effort collectif, garantissant ainsi la robustesse et la scalabilité des systèmes algorithmiques de votre organisation.