Infrastructure
Comprendre les frontières entre SRE et DevOps : culture, indicateurs de fiabilité et structuration des équipes
La convergence entre le développement et les opérations suscite souvent des confusions conceptuelles. Si la philosophie DevOps pose les fondations d'une collaboration unifiée, l'ingénierie de fiabilité des sites (SRE) en constitue une implémentation pragmatique. Vous devez saisir ces nuances pour structurer efficacement vos équipes technologiques.
L'émergence d'un paradigme de fiabilité par l'ingénierie logicielle
La dichotomie historique entre les équipes de conception logicielle et les administrateurs systèmes a longtemps généré des frictions opérationnelles sévères. Les concepteurs cherchaient à introduire des fonctionnalités inédites avec une vélocité maximale tandis que les exploitants privilégiaient la stabilité absolue de l'infrastructure. La philosophie DevOps a proposé une réponse culturelle à cet antagonisme en prônant une responsabilité partagée. Toutefois, cette approche conceptuelle manquait souvent de directives pragmatiques pour son application technique quotidienne. C'est précisément ici que l'ingénierie de fiabilité des sites, couramment désignée par l'acronyme SRE, intervient. Conçue initialement par les ingénieurs de Google, la discipline SRE applique les principes rigoureux de l'ingénierie logicielle aux problématiques complexes d'exploitation.
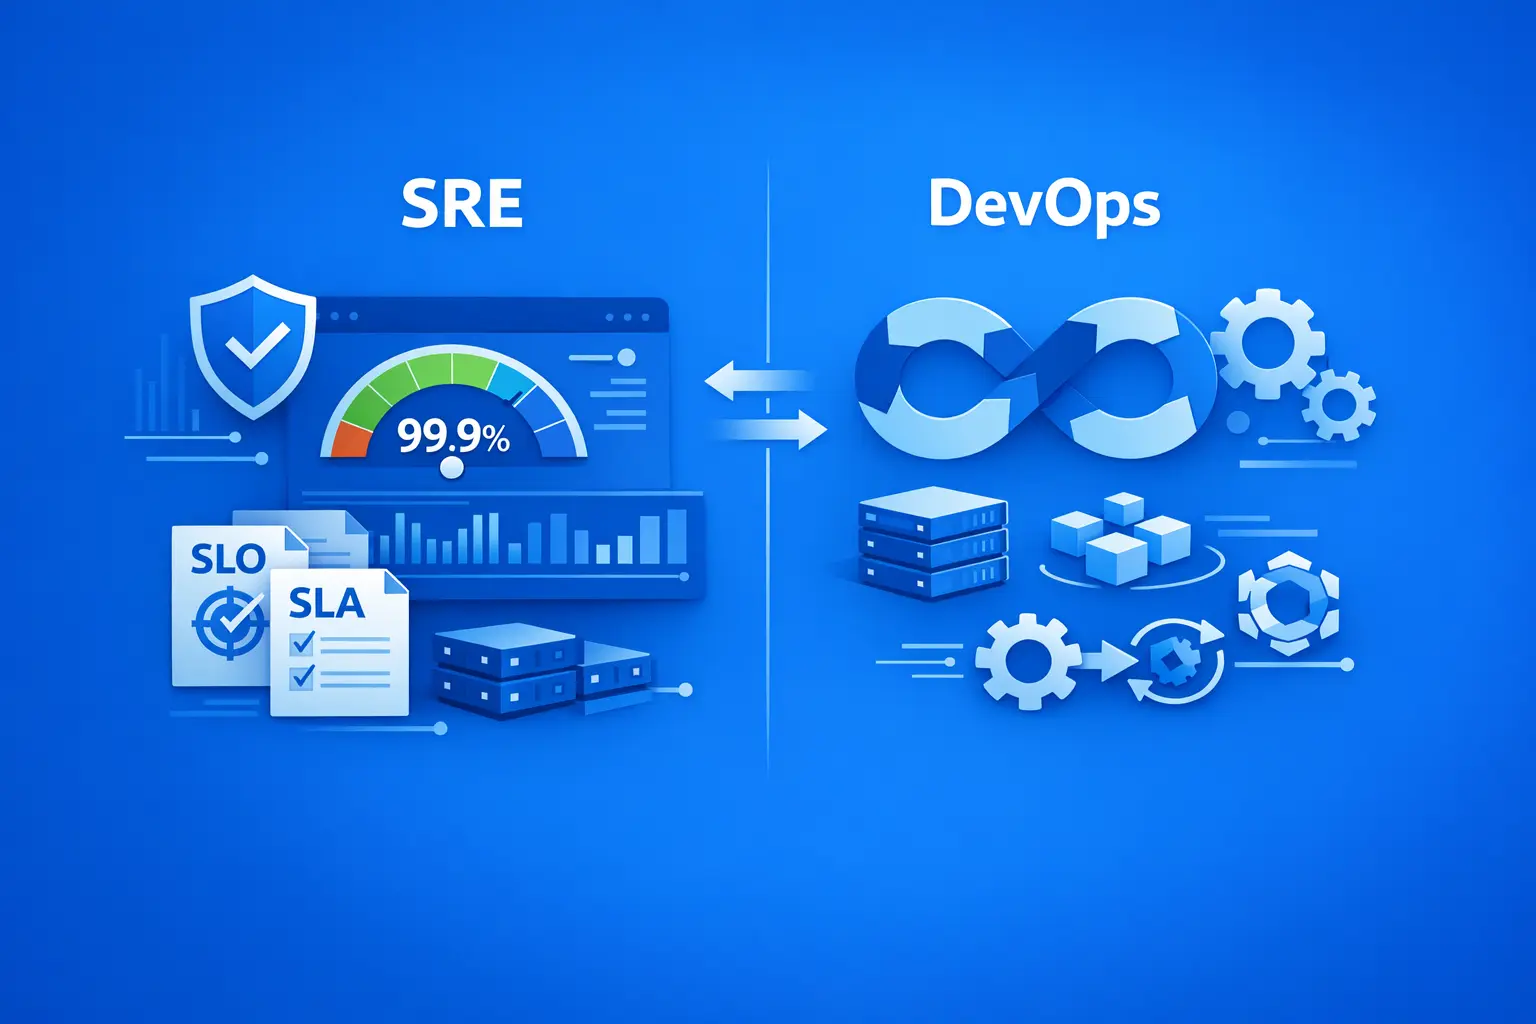
Si DevOps définit les objectifs collaboratifs à atteindre pour briser les silos organisationnels, le SRE fournit les méthodes mathématiques et les structures techniques pour y parvenir. Le professionnel SRE aborde les incidents, la montée en charge et la résilience comme des problèmes de développement nécessitant des solutions algorithmiques ou des refontes architecturales. Cette posture modifie fondamentalement la perception de la fiabilité au sein des directions informatiques. Celle-ci n'est plus considérée comme une simple conséquence d'une bonne administration système mais comme une fonctionnalité intrinsèque et prioritaire du produit numérique.
La devise célèbre du mouvement DevOps prônant que les créateurs d'une application doivent également en assurer l'exploitation constitue un excellent moteur de responsabilisation. Néanmoins, cette injonction philosophique n'explique pas concrètement comment opérer une plateforme lorsque celle-ci passe à l'échelle pour servir des millions d'utilisateurs simultanés. L'ingénierie SRE comble ce vide méthodologique en apportant des pratiques éprouvées pour gérer l'hyper-croissance. Les ingénieurs spécialisés conçoivent des architectures internes permettant de standardiser les opérations de maintenance complexes tout en garantissant une isolation parfaite des environnements critiques. L'avènement des architectures cloud-natives distribuées a considérablement amplifié cette nécessité. La gestion de milliers de conteneurs éphémères, la configuration de maillages de services complexes et l'orchestration des flux asynchrones rendent les processus traditionnels totalement obsolètes. Une plateforme indisponible rend toutes ses autres fonctionnalités parfaitement inutiles pour l'utilisateur final. Par conséquent, la fiabilité devient la métrique cardinale sur laquelle s'alignent toutes les décisions stratégiques et les investissements technologiques.
La gouvernance par la donnée : comprendre les indicateurs de service
La distinction majeure entre une simple collaboration inter-équipes et une véritable démarche de fiabilité réside dans l'utilisation rigoureuse de la télémétrie. Le pilotage d'une architecture distribuée complexe exige une taxonomie précise des indicateurs de performance. Les acronymes SLA, SLO et SLI structurent cette gouvernance métrique avec une précision mathématique indispensable.
Le SLA, ou accord de niveau de service, constitue un contrat commercial contraignant liant un fournisseur technologique à ses clients finaux. Il définit les pénalités financières applicables si le service ne respecte pas les engagements contractuels de disponibilité. Le SLO, ou objectif de niveau de service, représente quant à lui une cible interne fixée par les équipes d'ingénierie. Cet objectif doit systématiquement être plus strict que le SLA pour garantir une marge de sécurité opérationnelle confortable. Si le SLA promet une disponibilité de 99,9%, le SLO sera typiquement configuré à 99,95%. Enfin, le SLI, ou indicateur de niveau de service, correspond à la mesure technique brute extraite des systèmes de surveillance en temps réel.
La définition d'un SLI pertinent exige d'abandonner les moyennes arithmétiques basiques au profit des percentiles. Mesurer le temps de réponse moyen masque souvent les dégradations subies par une minorité significative d'utilisateurs. Les architectes privilégient l'analyse du 95ème ou du 99ème percentile pour garantir une expérience optimale. Pour établir une observabilité pertinente, les ingénieurs sélectionnent généralement des indicateurs spécifiques permettant de refléter la réalité du terrain :
- La latence des requêtes pour évaluer le temps de réponse perçu lors des interactions complexes avec la base de données.
- Le taux d'erreur mesurant la proportion de requêtes échouées par rapport au volume total de trafic entrant sur les répartiteurs de charge.
- Le débit global quantifiant la capacité de l'infrastructure réseau à traiter une charge simultanée massive sans dégradation.
- La disponibilité système reflétant le temps de fonctionnement effectif des microservices critiques sur une fenêtre glissante.
- La saturation des ressources matérielles permettant d'anticiper les goulots d'étranglement capacitaires avant qu'ils n'impactent les performances applicatives.
- La durabilité des informations garantissant l'intégrité absolue des données lors des opérations d'écriture distribuée entre plusieurs centres de calculs.
Le budget d'erreur comme mécanisme de régulation architecturale
L'un des concepts les plus puissants introduits par l'approche SRE réside dans la gestion mathématique du budget d'erreur. Viser une fiabilité absolue de 100% constitue une erreur stratégique coûteuse et techniquement irréalisable. Chaque fraction de pourcentage de disponibilité supplémentaire exige des investissements architecturaux exponentiels impliquant souvent des redondances complexes. Le budget d'erreur correspond à l'inverse exact du SLO. Pour un objectif fixé à 99,9%, le système s'autorise délibérément 0,1% d'indisponibilité sur une période mensuelle ou trimestrielle.
Ce budget agit comme un mécanisme de régulation objectif entre la vélocité de livraison des équipes produit et la stabilité requise par l'infrastructure. Tant que le budget d'erreur reste positif, les concepteurs conservent la liberté d'introduire de nouvelles fonctionnalités ou de procéder à des modifications architecturales majeures. Dès que ce capital se trouve épuisé, la gouvernance technique impose un changement de posture immédiat et non négociable. Les efforts d'ingénierie sont obligatoirement réorientés vers la stabilisation du système, l'amélioration de la résilience globale ou la résolution de la dette technique accumulée.
L'épuisement de ce budget ne constitue pas une sanction punitive mais une mesure de sauvegarde vitale pour l'entreprise. Concrètement, cette période de gel permet aux équipes de se concentrer sur des chantiers techniques souvent négligés lors des phases de développement intensif. Les ingénieurs en profitent pour optimiser les requêtes lourdes pénalisant les bases de données, pour affiner les seuils de déclenchement des alertes de supervision ou pour repenser la topologie des réseaux virtuels. Cette respiration architecturale garantit que la dette technique ne s'accumule pas jusqu'au point de rupture irréversible.
Cette mécanique dépersonnalise totalement les conflits historiques entre les concepteurs et les exploitants. Les décisions ne reposent plus sur des opinions divergentes ou des rapports de force hiérarchiques mais sur des données factuelles partagées par l'ensemble des parties prenantes. L'adoption d'un tel modèle exige un soutien inconditionnel de la direction générale car il implique d'accepter le gel temporaire des nouvelles fonctionnalités au profit de la fiabilité à long terme. La négociation de ce budget devient un exercice de gestion des risques associant les responsables produits, les garants des enjeux métiers et les experts en fiabilité.
L'organisation opérationnelle et la redéfinition des rôles techniques
La structuration quotidienne des départements technologiques illustre parfaitement les divergences pratiques entre les deux approches. Une culture DevOps réussie implique que chaque ingénieur prenne en compte les contraintes d'exploitation dès la phase initiale de conception. Cependant, cette diffusion généralisée des responsabilités peut parfois diluer l'expertise spécifique requise pour administrer des systèmes distribués à très grande échelle. À l'inverse, l'ingénierie de fiabilité instaure des rôles dédiés dotés d'un mandat technique extrêmement clair.
L'organisation du travail d'un ingénieur SRE obéit à des règles strictes de répartition du temps opérationnel. La théorie fondamentale de la discipline stipule qu'un expert ne doit jamais consacrer plus de la moitié de son activité aux tâches d'exploitation classiques telles que la gestion des tickets de support, les astreintes techniques ou les interventions manuelles d'urgence. Si ce seuil critique est franchi, cela indique une défaillance systémique nécessitant une intervention structurelle. Dans un tel scénario, le surplus de charge opérationnelle est temporairement transféré aux équipes de conception pour les forcer à prioriser la correction des défauts de fiabilité.
Le reste du temps disponible est impérativement sanctuarisé pour des activités d'ingénierie à très haute valeur ajoutée. Ces experts se concentrent sur deux axes prioritaires visant à pérenniser l'infrastructure :
- L'ingénierie logicielle appliquée à la conception d'architectures résilientes capables de supporter des pannes matérielles massives sans aucun impact perceptible pour l'utilisateur.
- L'analyse systémique des flux de télémétrie pour anticiper les dégradations de performance avant qu'elles ne déclenchent des alertes critiques nécessitant une intervention humaine.
Notre cabinet d'expertise technologique Dexon accompagne activement les directions informatiques dans cette restructuration délicate. La transition vers ce modèle organisationnel nécessite de revoir intégralement les fiches de poste, de redéfinir les critères d'évaluation des performances individuelles et d'instaurer de nouveaux rituels de synchronisation entre les entités produit et les cellules de fiabilité.
L'élimination du travail itératif par la conception de systèmes autonomes
L'approche SRE déclare une guerre méthodique au travail manuel répétitif couramment qualifié de labeur opérationnel. Ce concept désigne les interventions tactiques dépourvues de valeur pérenne qui augmentent de manière linéaire avec la croissance du système informatique. Contrairement aux approches traditionnelles d'administration qui acceptent ces tâches comme une fatalité inhérente au métier, l'ingénierie de fiabilité cherche à les éradiquer par la conception proactive de systèmes autonomes et auto-réparateurs.
La stratégie de remédiation repose sur l'implémentation de mécanismes d'intelligence opérationnelle et de gestion dynamique des capacités. Lorsqu'une charge exceptionnelle frappe l'infrastructure de production, le système ne doit pas se contenter d'émettre une alerte réveillant un ingénieur d'astreinte en pleine nuit. L'architecture doit être minutieusement conçue pour provisionner automatiquement de nouvelles ressources de calcul, ajuster les règles de répartition de charge réseau et dégrader gracieusement les fonctionnalités non essentielles. L'objectif ultime consiste à transformer les incidents prévisibles en événements gérés silencieusement par la plateforme elle-même.
L'analyse de nos références démontre de manière univoque que les organisations réussissant cette transition limitent drastiquement la fatigue opérationnelle de leurs collaborateurs. En remplaçant les procédures documentées obsolètes par du code d'infrastructure strict, elles garantissent une exécution déterministe des opérations de maintenance. La configuration des réseaux privés virtuels, le dimensionnement des clusters de bases de données distribuées et la gestion des politiques de sécurité deviennent des artefacts versionnés, auditables et reproductibles à l'infini sans intervention humaine directe.
La gestion systémique des incidents par la culture de l'apprentissage
La gestion des défaillances constitue l'ultime différenciateur de la posture d'ingénierie de fiabilité. L'incident n'est plus perçu comme une anomalie honteuse devant être dissimulée mais comme une opportunité inestimable d'apprentissage organisationnel. Cette vision novatrice se matérialise par la pratique systématique des revues post-incident sans blâme.
Lorsqu'une panne majeure survient sur les environnements de production, l'investigation technique ne cherche jamais à identifier un coupable humain. Si un opérateur a commis une erreur critique en exécutant une commande inappropriée, l'analyse SRE considérera que le système global était fondamentalement défaillant puisqu'il a permis à une action humaine isolée de provoquer une interruption de service. L'erreur humaine est perçue comme un symptôme d'une mauvaise conception des interfaces ou d'un manque de garde-fous architecturaux. Les conclusions de ces enquêtes approfondies se traduisent systématiquement par des modifications techniques concrètes. Il peut s'agir de l'ajout de verrous de sécurité stricts au niveau des interfaces de programmation, de l'amélioration de la granularité de la surveillance prédictive ou de la refonte complète d'un composant réseau jugé particulièrement fragile.
Pour être véritablement efficace, la rédaction d'une revue post-incident obéit à un formalisme extrêmement rigoureux. Le document final doit impérativement comporter une chronologie détaillée des événements, une analyse des causes fondamentales s'appuyant sur des méthodologies reconnues et une liste d'actions de remédiation clairement assignées. Ces actions correctives ne sont pas de simples recommandations reléguées dans un document annexe. Elles intègrent directement le carnet de commandes des équipes d'ingénierie avec un niveau de priorité maximal garantissant ainsi que l'organisation tire un bénéfice tangible de chaque perturbation opérationnelle.
Cette culture de la transparence psychologique garantit que les défaillances sont documentées avec une précision chirurgicale. Les équipes partagent ouvertement les vulnérabilités de leurs systèmes respectifs ce qui favorise une élévation globale du niveau de résilience de l'entreprise entière. La fiabilité devient ainsi une discipline véritablement scientifique basée sur l'expérimentation continue, la mesure rigoureuse des déviations et l'adaptation architecturale permanente. L'introduction de pratiques avancées telles que l'ingénierie du chaos permet même de simuler des pannes matérielles de manière proactive pour valider les hypothèses de résilience avant qu'un véritable sinistre ne se produise.