Ingénierie des flux hétérogènes au sein des architectures logicielles
Historiquement, la conception des systèmes d'information reposait sur des architectures unimodales où chaque type de donnée nécessitait un pipeline de traitement spécifique. Le texte transitait par des API REST traditionnelles, les images étaient stockées sur des serveurs de fichiers statiques puis analysées par des modèles de vision par ordinateur dédiés tandis que la voix exigeait des moteurs de transcription isolés. Cette ségrégation technologique imposait une complexité architecturale considérable dès lors qu'il s'agissait de croiser les informations pour en extraire une valeur sémantique globale. L'avènement des modèles de fondation multimodaux bouleverse ce paradigme en unifiant mathématiquement le traitement de ces informations.
Désormais, vous devez concevoir des applications capables de capturer, de synchroniser et de transmettre des flux polymorphes vers un point d'inférence unique. L'orchestration de ces données exige une révision complète des couches d'intégration. Lorsqu'un utilisateur interagit avec une application en dictant une requête vocale tout en filmant son environnement avec la caméra de son appareil, le système doit aligner temporellement la piste audio et le flux vidéo avant de les soumettre au modèle. Cette nécessité d'alignement temporel impose le recours à des protocoles de communication bidirectionnels à faible latence tels que WebSockets ou WebRTC.
La gestion de la charge utile devient une préoccupation centrale pour les architectes. Contrairement à une simple chaîne de caractères JSON, une requête multimodale peut contenir plusieurs mégaoctets de données binaires. Vous devez par conséquent mettre en place des mécanismes de compression sans perte, de redimensionnement dynamique des images et d'échantillonnage intelligent des trames vidéo côté client. L'objectif consiste à réduire la taille de la charge utile sans altérer la qualité des signaux nécessaires à la bonne compréhension du contexte par le modèle d'intelligence artificielle.
L'intégration de ces flux soulève également des défis liés à la persistance des données. Les bases de données relationnelles classiques ne sont pas conçues pour stocker efficacement des représentations vectorielles issues de modèles polymorphes. Les architectures modernes s'orientent vers des solutions hybrides couplant un stockage objet pour les fichiers bruts avec des bases de données vectorielles spécialisées.
Représentation vectorielle unifiée et espaces latents partagés
Pour comprendre comment une application peut traiter conjointement une image, une phrase et un extrait sonore, il convient de s'intéresser à la mécanique interne des modèles multimodaux. Le cœur de cette technologie repose sur la projection de données hétérogènes vers un espace latent partagé. Concrètement, un encodeur spécifique transforme le texte en vecteurs mathématiques pendant qu'un encodeur visuel découpe l'image en fragments pour les convertir dans le même format mathématique.
L'innovation réside dans l'alignement sémantique de ces vecteurs. Dans cet espace multidimensionnel, le vecteur représentant la photographie d'un serveur informatique se situe à proximité immédiate du vecteur correspondant à la phrase décrivant ce même équipement. Cette convergence vectorielle permet au système d'effectuer des opérations d'attention croisée. Le modèle peut ainsi pondérer l'importance d'un mot spécifique en fonction d'un détail visuel précis présent dans l'image soumise par l'utilisateur.
En tant que concepteurs de systèmes complexes, vous devez exploiter cette caractéristique pour élaborer des architectures de génération augmentée par la recherche (RAG) multimodales. Dans un tel système, la base de connaissances ne se limite plus à des documents textuels. Vous pouvez indexer des manuels de maintenance au format PDF, des schémas techniques, des photographies de pièces défectueuses et des enregistrements audio de diagnostics précédents. Lorsqu'une requête est formulée, le moteur de recherche vectoriel identifie les fragments pertinents indépendamment de leur format d'origine pour fournir un contexte enrichi au modèle de génération.
Cette approche nécessite deux stratégies distinctes d'intégration au niveau de l'architecture logicielle :
- La fusion précoce (Early Fusion) : Les données brutes sont combinées dès leur ingestion pour former une représentation unique avant de traverser les couches d'attention du réseau de neurones.
- La fusion tardive (Late Fusion) : Chaque modalité est traitée de manière asynchrone par des sous-réseaux spécialisés dont les résultats probabilistes sont agrégés lors de la phase finale de décision.
Le choix entre ces deux paradigmes dictera la structure de vos microservices ainsi que la répartition de la charge de calcul sur votre infrastructure.
Dimensionnement matériel des infrastructures de calcul
Le déploiement d'applications exploitant l'intelligence artificielle multimodale exerce une pression considérable sur les ressources matérielles. L'analyse simultanée de flux vidéo en temps réel et de requêtes textuelles complexes requiert une puissance de calcul massivement parallèle. L'utilisation exclusive de processeurs centraux (CPU) s'avère totalement inadaptée pour ces charges de travail. Vous devez impérativement orienter vos choix d'infrastructure vers des accélérateurs matériels spécialisés tels que les unités de traitement graphique (GPU) ou les processeurs tensoriels (TPU).
La bande passante de la mémoire vidéo constitue le goulot d'étranglement principal lors de l'inférence. Le chargement des paramètres d'un modèle multimodal de grande taille monopolise plusieurs dizaines de gigaoctets de VRAM. Lorsque vous traitez des requêtes concurrentes impliquant des images haute résolution ou des séquences vidéo, l'encombrement de la mémoire s'accroît de manière exponentielle en raison de la taille du contexte à conserver.
Nos architectes chez site accompagnent régulièrement les directions des systèmes d'information dans l'évaluation de ces contraintes physiques. L'arbitrage entre une exécution locale sur des serveurs hébergés en propre (On-Premise) et le recours à des interfaces de programmation gérées par des fournisseurs cloud conditionne la viabilité économique du projet. L'exécution locale garantit une maîtrise absolue de la confidentialité des données mais exige un investissement initial colossal en matériel. À l'inverse, l'utilisation de services managés transforme les dépenses d'investissement en coûts d'exploitation variables tout en posant des questions de souveraineté.
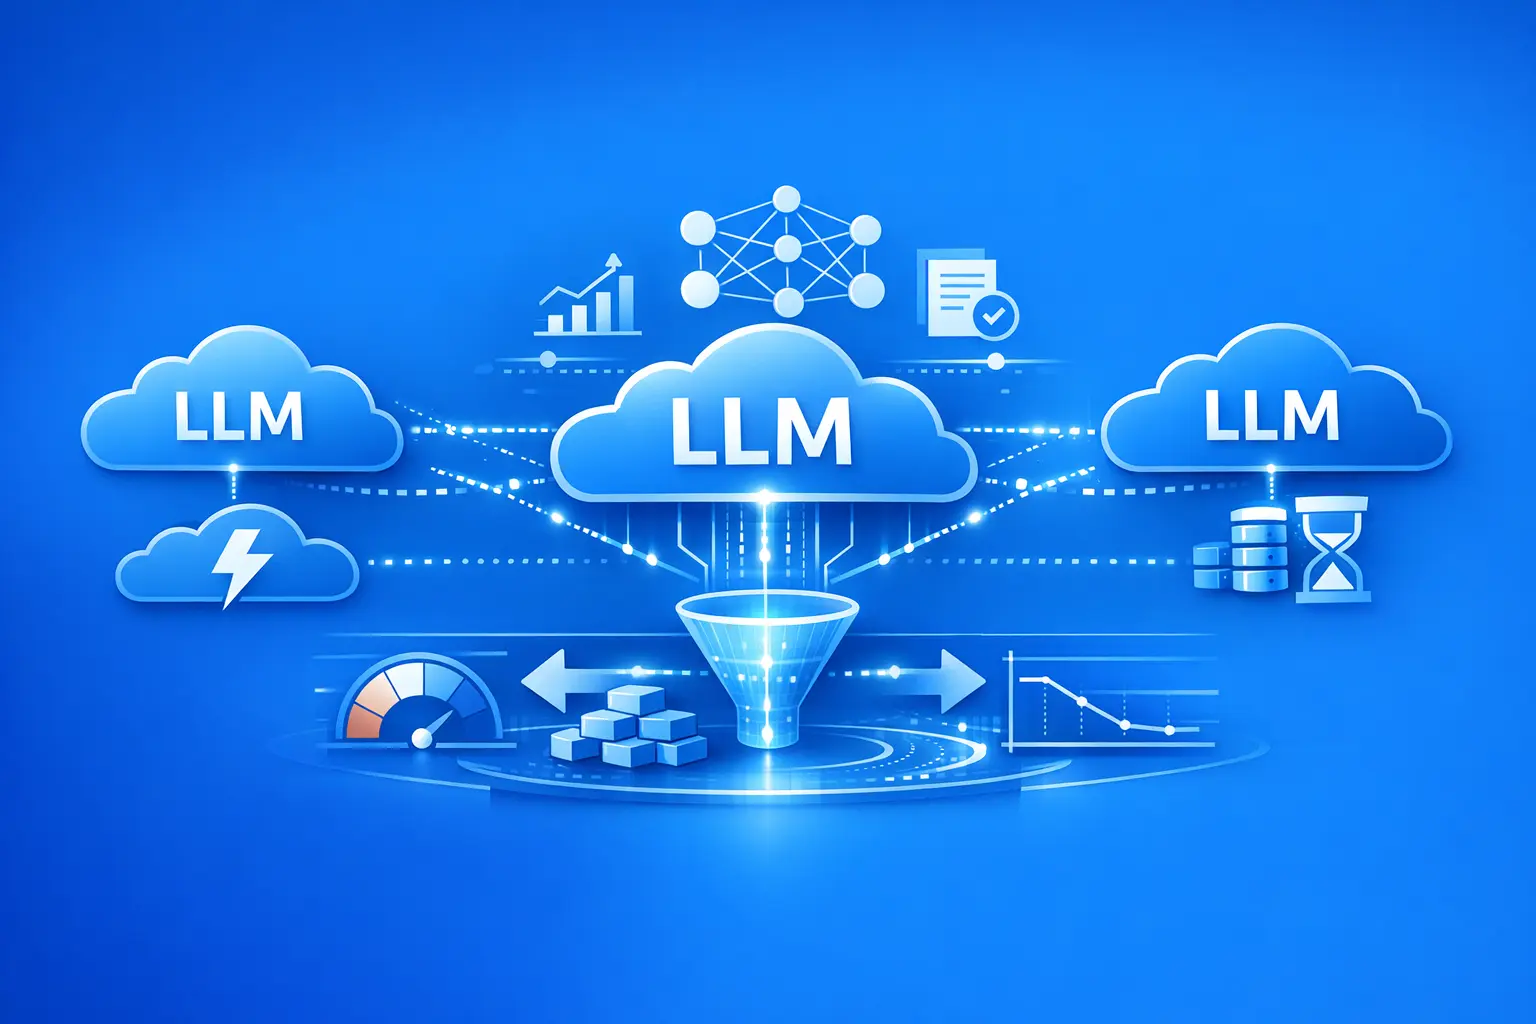
Pour dimensionner correctement une architecture multimodale destinée à un environnement de production, vous devez systématiquement modéliser les paramètres suivants :
- La bande passante réseau minimale requise pour l'acheminement des flux vidéo continus depuis les terminaux clients jusqu'aux serveurs d'inférence.
- La capacité totale de mémoire vive vidéo (VRAM) indispensable pour maintenir les poids du modèle en mémoire cache.
- La latence d'inférence acceptable pour garantir une interaction fluide lors du traitement synchrone de la voix.
- Les coûts d'exploitation marginaux liés à l'utilisation d'interfaces de programmation (API) facturées au volume de données traitées.
- La tolérance aux pannes des mécanismes de routage des requêtes vers des grappes de serveurs géographiquement réparties.
- La ségrégation physique des environnements de traitement pour isoler hermétiquement les données sensibles soumises au secret industriel.
- Les stratégies de mise en cache sémantique permettant de court-circuiter l'inférence pour des requêtes visuelles ou textuelles récurrentes.
Ces exigences infrastructurelles imposent une collaboration étroite entre les équipes d'ingénierie logicielle et les administrateurs systèmes pour concevoir des topologies réseau résilientes.
Sécurisation des entrées polymorphes face aux vulnérabilités émergentes
L'élargissement de la surface d'attaque constitue la conséquence la plus critique de l'intégration multimodale. Historiquement, la sécurisation des modèles de langage se concentrait sur la détection d'injections de requêtes (Prompt Injection) dissimulées dans le texte. L'introduction de l'image, de l'audio et de la vidéo démultiplie les vecteurs de compromission potentiels. Un acteur malveillant peut désormais intégrer des instructions destructrices directement dans les pixels d'une image en utilisant des techniques de stéganographie avancées.
Ces attaques visuelles sont conçues pour être indétectables par l'œil humain tout en étant parfaitement interprétables par le réseau de neurones. Lorsqu'une telle image est soumise à l'application, le modèle extrait les instructions cachées et peut les exécuter en contournant les filtres de sécurité textuels classiques. De la même manière, des fréquences inaudibles insérées dans un fichier audio peuvent forcer un assistant vocal à déclencher des actions non autorisées.
Vous devez concevoir des architectures de sécurité de type défense en profondeur. La première ligne de défense implique la mise en place de pare-feu applicatifs spécifiques à l'intelligence artificielle (AI Gateway). Ces composants se chargent d'inspecter les charges utiles multimodales avant leur transmission au modèle de fondation. L'inspection consiste à normaliser les images, à filtrer les fréquences sonores suspectes et à appliquer des algorithmes de détection d'anomalies sur les vecteurs générés.
La confidentialité des données soumises par les utilisateurs nécessite une attention particulière. Lorsqu'une application demande l'accès à la caméra d'un appareil mobile pour identifier un objet, elle capture inévitablement des éléments de l'environnement en arrière-plan. Ces éléments peuvent inclure des visages, des documents confidentiels posés sur un bureau ou des informations de géolocalisation. Vous devez intégrer des mécanismes de floutage dynamique ou de recadrage algorithmique exécutés côté client avant toute transmission vers les serveurs de traitement. Cette approche garantit le respect des réglementations relatives à la protection des données personnelles en limitant l'exposition des informations sensibles.
Convergence des interfaces et cas d'usage industriels
La maîtrise technique de l'intelligence artificielle multimodale permet de repenser intégralement l'expérience utilisateur des applications métier. L'interface logicielle ne se limite plus à des formulaires de saisie ou à des barres de recherche statiques. Elle se transforme en un agent cognitif capable de percevoir l'environnement physique de l'utilisateur pour lui fournir une assistance contextuelle pertinente.
Dans le secteur de la maintenance industrielle, les applications mobiles traditionnelles obligent les techniciens à naviguer dans des menus complexes pour documenter une intervention. Une architecture multimodale permet de remplacer cette interaction fastidieuse par un flux continu. Le technicien peut diriger la caméra de sa tablette vers un équipement défectueux tout en décrivant le problème vocalement. L'application synchronise le flux vidéo pour identifier la référence exacte de la machine, transcrit la description audio, analyse les voyants d'erreur visibles sur l'image et interroge la documentation technique pour formuler un diagnostic immédiat.
Le domaine médical bénéficie également de cette convergence technologique. Les systèmes d'information hospitaliers modernes intègrent des capacités d'analyse croisée entre les notes cliniques textuelles, les radiographies et les enregistrements des consultations. Cette agrégation de modalités hétérogènes offre aux praticiens une vue holistique du dossier patient facilitant la détection précoce de pathologies complexes. Comme l'illustrent certaines de nos références, le déploiement de telles solutions exige une architecture robuste capable de garantir un cloisonnement strict des données de santé.
Le commerce électronique exploite ces technologies pour combler le fossé entre l'intention d'achat et la formulation de la requête. Les consommateurs peuvent soumettre la photographie d'un meuble repéré dans un magazine tout en précisant par écrit qu'ils recherchent un modèle similaire dans un matériau différent. Le moteur de recherche vectoriel traite cette requête hybride en croisant les caractéristiques visuelles de l'image source avec les contraintes textuelles ajoutées par l'utilisateur.
La mise en œuvre de ces fonctionnalités complexes ne relève plus de la science-fiction mais d'une ingénierie logicielle rigoureuse. La réussite de vos projets dépendra de votre capacité à structurer des architectures résilientes, à maîtriser la consommation des ressources matérielles et à anticiper les vecteurs d'attaque inhérents à la manipulation de flux de données polymorphes.